그록 4.5가 지난 7월 8일(현지시간) 공개됐습니다. xAI가 “역대 가장 똑똑한 모델”이라고 자신하는 이번 모델은 코딩과 에이전트 작업에 초점을 맞췄는데, 무엇보다 가격표가 눈에 띕니다. 입력 100만 토큰당 2달러, 출력 6달러. 클로드 오퍼스 4.8과 비교하면 출력 기준 약 4분의 1 수준입니다. 싸고 빠르다는 그록 4.5, 과연 실력까지 갖췄을까요? 공식 발표와 독립 벤치마크 결과를 함께 뜯어봤습니다.
그록 4.5, 뭐가 달라졌나
이번 그록 4.5는 소비자용 챗봇보다 코딩과 에이전트 작업에 무게를 실은 모델입니다. 엔비디아 GB300 GPU 수만 장으로 훈련했고, 코드 에디터 회사 커서(Cursor)와 함께 실제 개발 세션 데이터를 학습에 활용한 점이 특징입니다. 강화학습도 수십만 개의 소프트웨어 엔지니어링 과제를 중심으로 대규모로 진행했다고 밝혔습니다.
컨텍스트 윈도우는 50만 토큰이고, 추론 강도는 low·medium·high 3단계로 조절할 수 있습니다. 웹 검색과 X 검색, 코드 실행 같은 서버사이드 도구가 기본 내장돼 있어서 별도의 검색 파이프라인을 직접 연결하지 않아도 됩니다. 실무에서 에이전트를 굴려 본 분이라면 이 부분이 얼마나 손이 덜 가는 변화인지 아실 겁니다.
가격표가 곧 전략이다
그록 4.5의 API 가격은 입력 100만 토큰당 2달러, 출력 6달러입니다. 캐시된 입력은 0.5달러로 75% 할인이 적용됩니다. 최상위권 성능을 표방하는 모델 중에서는 눈에 띄게 공격적인 가격입니다.
여기에 토큰 효율이 더해집니다. SWE Bench Pro 과제 하나를 푸는 데 그록 4.5는 평균 15,954 토큰을 쓰는 반면, 오퍼스 4.8(max)은 67,020 토큰을 씁니다. 약 4.2배 차이입니다. 단가가 싼 데다 토큰 자체를 덜 쓰니, 실제 작업 단위 비용 차이는 표시 가격보다 훨씬 크게 벌어집니다. 서빙 속도도 초당 80토큰으로 사실상 경량 모델급입니다.
벤치마크로 본 그록 4.5의 진짜 위치
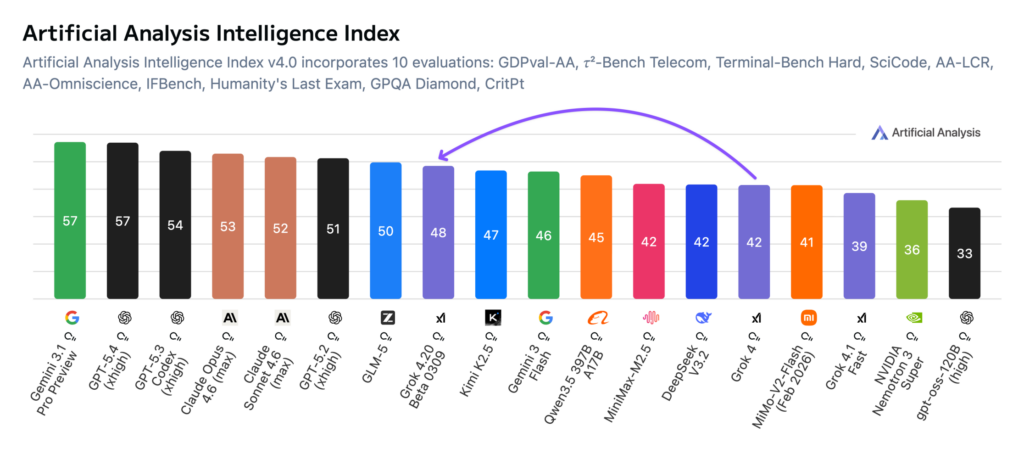
독립 평가 기관 아티피셜 애널리시스(Artificial Analysis)의 인텔리전스 인덱스에서 그록 4.5는 168개 모델 중 4위(54점)에 올랐습니다. 특히 에이전트 도구 사용 항목에서는 전체 1위를 기록했습니다.
코딩 절대 성능은 아직 2인자
다만 개별 벤치마크를 보면 그림이 조금 달라집니다. SWE Bench Pro에서 그록 4.5는 64.7%로, 클로드 오퍼스 4.8(69.2%)과 클로드 페이블(80.4%)에는 못 미칩니다. 자체 발표 자료에서도 코딩 절대 성능 항목은 상위 모델에 밀리는 결과가 섞여 있습니다.
장거리 에이전트 작업에서는 1위
반면 장시간 에이전트 작업을 측정하는 SWE 마라톤에서는 29.0%로 오퍼스 4.8(26.0%)을 제치고 1위였고, 터미널 벤치 2.1도 83.3%로 최상위권입니다. 요약하면 “절대 지능 1등은 아니지만, 프런티어 바로 아래에서 가장 싸고 빠른 모델”이라는 위치입니다.
가성비 프런티어 경쟁이 시작됐다
솔직히 이번 발표에서 가장 흥미로운 건 개별 점수보다 시장 구도입니다. 불과 열흘 사이에 GPT-5.6 솔·테라·루나가 가격대별 3종 체제로 나왔고, 그록 4.5가 그 한가운데인 2달러/6달러 지점을 정확히 겨냥해 들어왔습니다. 이제 프런티어 경쟁은 “누가 제일 똑똑한가”에서 “같은 지능을 누가 제일 싸게 파는가”로 넘어가는 분위기입니다. OpenAI가 자체 칩 할라페뇨로 원가 절감에 뛰어든 것도 같은 맥락이라고 봅니다.
내 예상으로는 이 가격 전쟁이 올해 하반기 내내 이어질 것 같습니다. 토큰 효율이 곧 마진이 되는 구조라서, 다음 세대 모델부터는 벤치마크 점수 옆에 ‘과제당 토큰 수’가 기본 스펙처럼 붙지 않을까 싶습니다.
아쉬운 점과 남는 의문
물론 걸리는 부분도 있습니다. 출시 시점에 EU에서는 쓸 수 없고, 유럽 지역 제공은 7월 중순으로 예고돼 있습니다. 그리고 발표 자료의 벤치마크 상당수가 xAI가 직접 고른 항목이라는 점도 감안해야 합니다. 실제로 독립 벤치마크에서는 코딩 절대 성능이 경쟁 모델에 밀리는 항목이 분명히 존재합니다.
근데 한 가지 의문이 더 듭니다. 커서의 실제 개발 세션 데이터를 훈련에 활용했다는 부분인데요. 성능에는 확실히 도움이 됐겠지만, 개발자들의 작업 데이터가 어디까지 학습에 쓰이는지에 대한 논쟁은 앞으로 커질 수밖에 없어 보입니다.
지금 써봐야 할까
결론부터 말하면, 코딩 에이전트 용도라면 한 번 써볼 가치가 충분합니다. 지금 그록 4.5는 Grok Build와 커서(Cursor) 전 요금제에서 한시적으로 무료로 열려 있어서 부담 없이 비교해 볼 수 있습니다. 자세한 내용은 xAI 공식 발표에서 확인할 수 있습니다.
제 기준을 말씀드리면 이렇습니다. 최고 품질이 필요한 복잡한 리팩터링은 여전히 상위 모델이 낫고, 반복적인 에이전트 작업과 대량 처리라면 그록 4.5의 비용 대비 효율을 이기기 어렵습니다. 1년 후에는 이런 “준프런티어 가성비 모델”이 실무 API 트래픽의 대부분을 가져가는 그림이 될 것 같습니다. 어느 쪽이든, 모델 가격이 이렇게 빠르게 내려가는 건 쓰는 사람 입장에서 반가운 일입니다. 여러분은 어떤 모델을 메인으로 쓰고 계신가요? 댓글로 의견을 남겨주세요.